斑海豹 · Phocinae-Largha-150M-v1
小海豹,大决断。 / Tiny model. Big decisions.
一斑见全豹,一点定全局。
Phocinae-Largha-150M-v1(斑海豹 Largha)是一个 144.3M 参数的双语类型化决策模型,不是聊天模型。输入一段状态文本 state 与一组带类型的提问(noul 是否 · choice 多选一 · score 2–10 打分),它在一次前向传播内返回带标定置信度的答案,输出零个生成 token,且答案对选项顺序不敏感。GPU 上单个决策 18.6 ms,权重 288.6 MB,无需 GPU 也能运行。Apache-2.0。
这是什么?
Phocinae-Largha-150M-v1(英文名 Largha,中文名斑海豹)是一个基于 jhu-clsp/mmBERT-small 微调的 encoder 决策模型,参数 144.3M。它被设计用来承担 AI Agent 会话里重复出现且选项封闭的决策——命令审批、工具选择、步骤校验、输出筛查——把这类调用从大模型 API 搬回本机执行。
它的判断方式不是"生成一段话再解析",而是把每个提问当作一次分类:问题类型决定输出形态,模型直接在封闭标签集上给出概率分布。因此它不采样、不产生格式解析失败、固定 batch 形状下逐位可复现。
它是什么 / 它不是什么
是:结构化决策 · 审批门 · 工具路由 · 置信度升级 · 文档分诊 · 步骤校验 · 输出筛查;任何需要"快、省、本地"决策层的地方。
不是:开放对话 / 文本生成 · 长文档推理 · 世界知识问答 · 唯一安全防线。
也不是:OpenAI 兼容接口 / Ollama 模型 / 聊天补全 API——官方运行时刻意不实现这些,因为它不是聊天模型。
关键事实
| 参数量 | 144.3M(safetensors 实测 total 144,292,870,dtype F16) |
|---|---|
| 结构 | mmBERT-small 基座:hidden 384 × 22 层 × 6 头,256k 词表,RoPE + 滑窗(128) + 每 3 层全局注意力;max_position_embeddings 8192 |
| 权重体积 | 288.6 MB(fp16)· sha256 db79d5ee2f16597f34e564f5a4363bddb5b5bbd9827c01819725dabcc7802697 |
| 推理内存 | 约 1.6 GB 显存 / 约 1.8 GB 内存 · 无 GPU 可运行 |
| 输出 | 零生成 token;noul=布尔 · choice=0 基下标 · score=2–10 整数,均附标定置信度 |
| 延迟 | GPU fp16 p50 18.6 ms/决策 · CPU 单线程 p50 1.51 秒/用例(约 0.28 秒/决策)· CPU 8 线程批处理 8–21 决策/秒 |
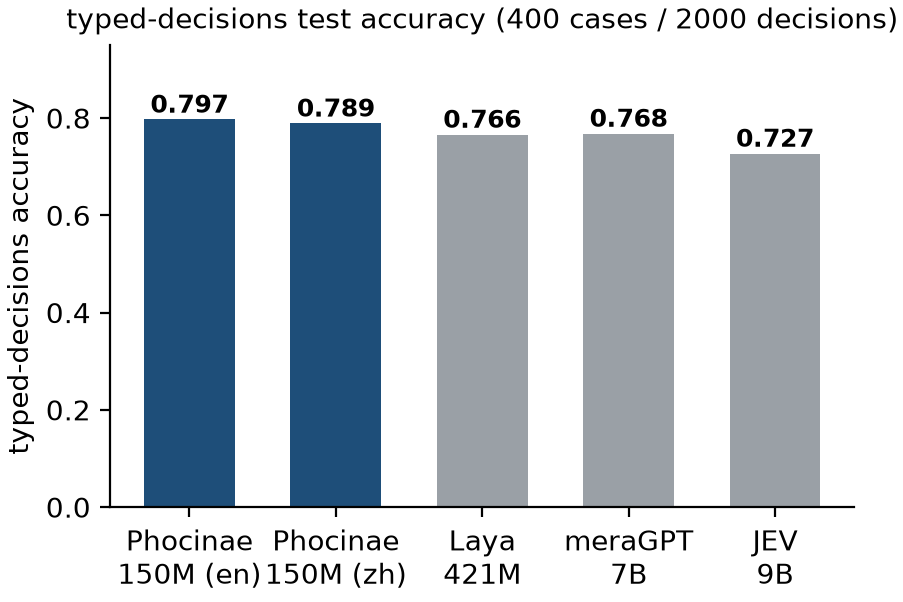
| 准确率 | typed-decisions en 0.797(400 用例 / 2000 决策)· zh 0.789(机翻用例,无中文原生训练行) |
| 同协议对照 | Laya 0.766 · JEV 0.727 · meraGPT 0.768 |
| 选项顺序翻转率 | 越低越好:CPU fp32 flip150 0.0300 · flip400 0.0300 · random-mean 0.0233 · any-of-3 0.0433 |
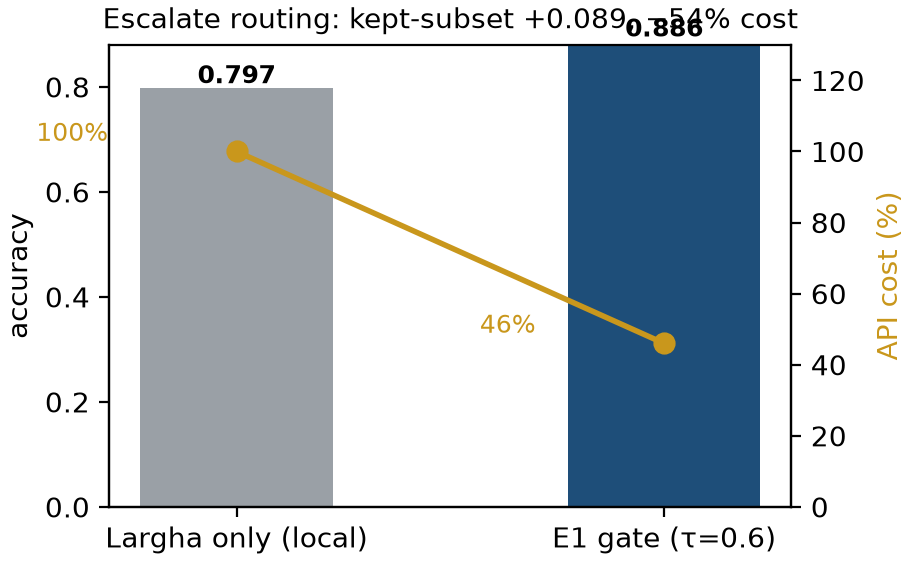
| 升级门收益 | τ=0.6:LLM 调用 −54.4%(τ=0.5 档 −82.8%),保留集准确率 0.797 → 0.886,45.7% 升级 |
| 标定 | 出厂列 ECE 0.1313(en);标定温度 0.7698 / 0.7879 / 0.7560,推理时应用 |
| 许可 | Apache-2.0(基座 jhu-clsp/mmBERT-small 为 MIT) |
快速开始
pip install phocinae-server
# 下载权重到本地目录,例如 ./largha
PHOC_MODEL_DIR=./largha python -m phocinae.main   # http://127.0.0.1:8155
一次决策:
curl -s http://127.0.0.1:8155/v1/systemone \
  -H 'Content-Type: application/json' -d '{
  "model": "Phocinae-Largha-150M-v1",
  "state": "The agent restarted nginx after checking the logs and the health endpoint is green.",
  "questions": [
    {"id": "ok",   "type": "noul",   "threshold": 0.65},
    {"id": "act",  "type": "choice", "options": ["allow", "ask", "deny"]},
    {"id": "risk", "type": "score"}
  ]
}'
服务只监听 127.0.0.1;一次请求最多 64 题,上下文预算 8192 token。协议全文见 docs/protocol.md。
常见问题
Phocinae-Largha-150M-v1 是什么?
一个 144.3M 参数的双语类型化决策模型(encoder-based),在 jhu-clsp/mmBERT-small 上微调。它接收状态文本与类型化问题,输出带标定置信度的答案,不做文本生成、不采样。
它和聊天模型 / 大语言模型有什么区别?
聊天模型生成 token,用它做"允许还是拒绝"这类决策要付出 500–4,000 token 的 API 往返与 1.5 秒以上延迟;本模型用一次前向传播、零输出 token 完成同一个决策,本地 18.6 ms(GPU)或约 0.28 秒/决策(CPU 单线程)。
什么时候该用它,什么时候该用大模型?
判断标准是"决策是否重复且选项封闭"。命令审批、工具选择(k≤10)、步骤校验、输出筛查属于此列,交给本机;开放式推理、多轮对话、长文档理解交给大模型。配合 τ=0.6 置信度门,只有 45.7% 的不确定决策会上行。
能省多少成本?
τ=0.6 升级门把 LLM 调用削减 54.4%(τ=0.5 档 82.8%),同时保留集准确率从 0.797 升到 0.886。按每月 1 万次被路由决策估算,约省 11.4M LLM token,约合 326 美元/年(按 Claude Sonnet 5 列表价、2026 年 10 月估算,仅为估算)。
需要什么硬件?
无 GPU 可运行:4 GB 内存 + 8 GB 存储即可试用(CPU 单线程 1.4–1.7 秒/用例)。推荐 16 GB 内存 + 8 GB 以上显存 + 512 GB NVMe,可达 18.6–25 ms/决策。
中文效果怎么样?
在机翻的英文用例上测得 0.789(英文同集 0.797)。没有中文原生训练行,请把中文成绩视为跨语言迁移证据,而不是中文优化结果。
可以直接用 transformers 加载吗?
不推荐。仓库根目录 config.json 的 architectures 仍是基座的 ModernBertForMaskedLM;用 AutoModelForSequenceClassification 得到的是基座分类头,并非训练好的 decision head,也不含标定温度。请使用官方运行时 phocinae-server(纯 PyTorch 自写前向,直读 safetensors)。
能当安全门或唯一防线用吗?
不能。它是一线决策辅助:需要与升级机制(τ=0.6 门会把 45.7% 不确定项交出去)和确定性规则层配合使用,绝不可作为破坏性/安全关键操作的唯一控制。
主要局限有哪些?
不擅长生成、长文档推理、世界知识问答;中文仅机翻;长输入退化(16k / 32k 探针 0.453 / 0.387);JevBench 公开集未达验收门槛(0.5108 vs 58.4%,已主动披露);尚无人口统计学/公平性评估。
从哪里下载?
GitHub(完整文档与复现材料)· Hugging Face · ModelScope 魔搭(国内推荐)。运行时:PyPI phocinae-server。
诚实披露
- JevBench public-231:0.5108(118/231),未达 58.4% 验收门槛。数字按实测发布,且从未在评测行上训练;tool_selection(k≤10)为 12/12。
- 中文成绩来自机翻用例,没有中文原生训练行。
- 翻转率按选项重排协议测量(越低越好):CPU fp32 0.0300 / 0.0300(flip150 / flip400 反向)· random-mean 0.0233 · any-of-3 0.0433。GPU fp16 0.027 / 0.028 与 1k 行 0.0187 / 0.0205 / 0.0431 是不同协议的备注值。
- 标定:出厂列 en ECE 0.1313。一项达到 0.0106 的推荐重标定列并未随权重发布。
引用
@misc{phocinae2026largha,
  title   = {Phocinae-Largha-150M-v1: A 144M-parameter bilingual typed decision model},
  author  = {Phocinae Project},
  year    = {2026},
  url     = {https://huggingface.co/Phocinae/Phocinae-Largha-150M-v1},
  license = {Apache-2.0}
}完整文档:README · BENCHMARKS.md · MODEL_CARD.md · 复现协议